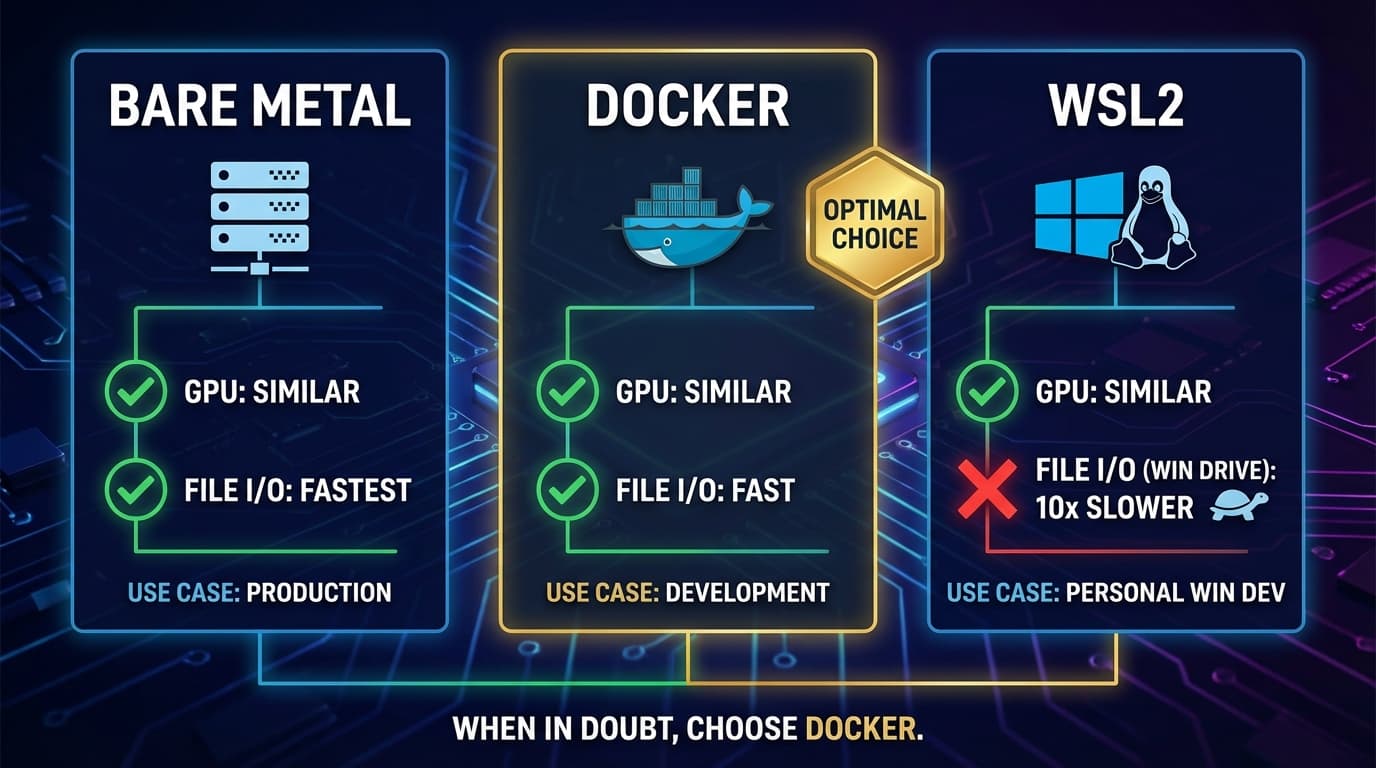
社内AI基盤の実行環境を選ぶ
社内AI基盤をPoCから本番運用へ移行する際は、GPU性能に加え、ファイルI/O、環境の再現性、管理・復旧のしやすさを確認する必要があります。
AI開発で使われる3つの実行環境を、DigitalBaseの検証データと構築実績に基づいて比較します。
- ベアメタル(ネイティブLinux):最高性能だが柔軟性に欠ける
- Docker:移植性と再現性に優れるが、わずかなオーバーヘッドがある
- WSL2:Windows上でのLinux開発を実現するが、独特の制約がある
3つの環境の基本特性
ベアメタル(ネイティブLinux)
OSがハードウェア上で直接動作する環境です。仮想化レイヤーを介さないため、ハードウェアリソースを最大限に活用できます。
代表的な構成
- Ubuntu Server 24.04 LTS
- NVIDIA Driver + CUDA を直接インストール
- Python仮想環境(venv, uv, conda)
Docker
コンテナ技術による軽量な仮想化環境です。アプリケーションとその依存関係を「コンテナ」としてパッケージ化し、環境を問わず同一に動作させられます。
代表的な構成
- Docker + Docker Compose
- NVIDIA Container Toolkit(GPU対応)
- 公式イメージ(pytorch/pytorch, nvidia/cuda 等)
WSL2(Windows Subsystem for Linux)
Windows上でLinuxカーネルを動作させる仕組みです。Windows環境を維持しながら、Linuxツールチェーンを利用できます。
代表的な構成
- WSL2 + Ubuntu 24.04
- CUDA on WSL(Windows側のNVIDIA Driver経由)
- VS Code Remote WSL連携
総合比較表
| 比較項目 | ベアメタル | Docker | WSL2 |
|---|---|---|---|
| パフォーマンス | ◎ 最高性能 | ◯ ほぼネイティブ | △ GPUは良好、I/Oに難 |
| セットアップ難易度 | △ 手動設定が多い | ◯ Dockerfileで自動化 | ◎ Windows環境なら最速 |
| 環境再現性 | △ 手動管理 | ◎ コード化可能 | ◯ 一定程度可能 |
| 移植性 | △ 環境依存 | ◎ どこでも動作 | △ Windows限定 |
| GPU対応 | ◎ 完全対応 | ◯ Container Toolkitで対応 | ◯ CUDA on WSLで対応 |
| マルチプロジェクト | △ 依存衝突リスク | ◎ 完全分離 | ◯ 仮想環境で対応 |
| 開発体験 | ◯ SSH経由が基本 | ◯ VS Code統合が良好 | ◎ Windowsツールと連携 |
| 本番運用 | ◎ 最も安定 | ◎ K8s等で自動化 | △ 本番利用は非推奨 |
詳細比較:パフォーマンス
GPU推論速度
7Bクラスのモデルを batch_size=1 で推論した際の実測値です。同一GPU・同一モデル・同一量子化条件で計測しています。
ベアメタル(Ubuntu 24.04)
- トークン生成速度:52 tok/s
- GPU利用率:95〜98%
- メモリ転送:最適
Docker(NVIDIA Container Toolkit)
- トークン生成速度:50 tok/s(約4%減)
- GPU利用率:93〜96%
- オーバーヘッド:軽微
WSL2(CUDA on WSL)
- トークン生成速度:48 tok/s(約8%減)
- GPU利用率:90〜94%
- Windows Driver経由のため若干の遅延
検証からの評価 GPU推論では3環境とも実用上の問題はありません。ベアメタルとDockerの差はほぼ誤差範囲です。WSL2も許容範囲ですが、大量バッチ処理では差が顕在化する場合があります。
ファイルI/O速度
最も大きな差が出るのがファイルI/Oです。
ベアメタル
- ローカルSSD:最速
- データローディング:基準値
Docker
- バインドマウント:ほぼネイティブ並み
- ボリューム:やや遅い(5〜10%)
- Windows/macOS上のDocker Desktop:大幅に遅い(50%以上)
WSL2
- WSL内ファイルシステム:ネイティブ並み
- Windowsドライブ(
/mnt/c/):極端に遅い(10倍以上になる場合あり)
データの配置先 WSL2ではLinux側のファイルシステム(
/home/以下)で作業し、Windowsドライブ経由は避けてください。大量の画像データやモデルファイルを扱う場合、処理時間に大きく影響します。
依存関係の管理
ベアメタル
- 利点:直接的で理解しやすい
- 欠点:複数プロジェクトで依存関係が衝突する
- 対策:Python仮想環境(venv, uv, conda)で分離
Docker
- 利点:完全に分離され、衝突がない
- 欠点:イメージサイズが大きくなりがち
- 対策:マルチステージビルドで最適化
WSL2
- 利点:Linuxツールがそのまま使える
- 欠点:Windows側との連携で混乱しやすい
- 対策:作業をWSL内で完結させる
デバッグとトラブルシューティング
ベアメタル
- システムログを直接確認でき、ハードウェアレベルの問題も把握しやすい
- ただし環境が壊れると復旧の負荷が高い
Docker
- コンテナのログが分離され、問題が起きてもコンテナを再作成すれば復旧できる
- ただしネットワークやボリュームの問題は切り分けが複雑になりがち
WSL2
- Windowsとの相互作用が絡むと切り分けが難しい
- ネットワーク設定が扱いにくく、WSLの再起動で解決するケースも多い
ユースケース別の推奨環境
プロトタイピング・PoC開発
推奨:WSL2 または Docker
素早く環境を構築でき、検証時の復旧も容易です。Windows PCでの検証にはWSL2、チームで環境を共有する場合はDockerが適します。
本番運用(オンプレミス)
推奨:ベアメタル または Docker(K8s)
最高性能と安定性を最優先し、長期運用を見据えます。単一サーバーのシンプルな構成ならベアメタル、複数サーバーやスケーラビリティ重視ならDockerが適します。
推論API提供(FastAPI等)
推奨:Docker
環境の再現性が高く、スケーリングとCI/CD統合が容易で、複数バージョンの並行運用にも向きます。
構成例:FastAPI + Uvicorn / NVIDIA Container Toolkit / Docker Compose または Kubernetes
運用上の注意点
ベアメタルでの注意点
① システム更新によるCUDA破損
# apt upgradeでNVIDIA Driverが壊れることがある
# 対策:ドライバを固定し、カーネル更新は慎重に
sudo apt-mark hold nvidia-driver-570
② 環境が壊れた際の復旧コストが高い
- 定期的なスナップショット取得を推奨
- 重要な設定は
/etc/をバックアップ
③ マルチユーザー環境での権限管理
# GPU使用権限をグループで管理
sudo usermod -a -G video $USER
Dockerでの注意点
① GPUリソースの指定
services:
  ai-service:
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]
② ボリュームマウントの性能
Windows/macOS上のDocker Desktopでは、バインドマウントが極端に遅くなることがあります。
# 対策:名前付きボリュームを使う
volumes:
  model-cache:

services:
  ai-service:
    volumes:
      - model-cache:/app/models
③ メモリ制限の設定
services:
  ai-service:
    mem_limit: 16g
    memswap_limit: 16g
コスト比較
初期セットアップコスト
| 環境 | 時間 | 学習コスト | 金銭コスト |
|---|---|---|---|
| ベアメタル | 2〜4時間 | 中〜高(Linux知識) | なし(既存サーバー利用時) |
| Docker | 1〜2時間 | 中(Docker知識) | なし |
| WSL2 | 30分〜1時間 | 低 | なし |
ランニングコスト
- ベアメタル:性能は最高だが、手動管理が多くメンテナンス工数が高い
- Docker:性能はほぼネイティブで、自動化しやすくメンテナンス工数が低い
- WSL2:I/O面で性能はやや劣る。メンテナンス工数は低いが、Windows PCのリソース占有に注意
実務での組み合わせパターン
多くのプロジェクトでは、フェーズに応じて複数の環境を使い分けています。
パターン1:開発から本番への典型的な流れ
- 開発フェーズ:WSL2でローカル開発。素早いプロトタイピングとWindowsツール(Excel等)の併用
- テスト・検証フェーズ:Dockerでコンテナ化。CI/CDで自動テストし、チームで環境を共有
- 本番運用フェーズ:ベアメタルまたはK8s上のDocker。最高性能と安定性を確保し、監視・ログ収集を整備
パターン2:チーム開発の標準構成
- 全員がDockerで統一し、
compose.ymlで環境を定義。「自分の環境では動く」問題を回避 - 本番もDocker(Kubernetes)とし、開発環境と本番環境の差を最小化
プロジェクト事例
事例1:医療記録AI
環境構成:開発はDocker(FastAPI + LangChain)、本番はベアメタル(Ubuntu Server)
選択理由:開発時は複数バージョンを並行検証し、本番は単一サーバーでの安定運用を重視しました。セキュリティ要件により、クラウドは利用できませんでした。
結果:Docker化で開発環境の構築を30分程度に短縮しました。本番はベアメタルで推論速度が約20%向上しました。
事例2:建築図面解析(CAD連携)
環境構成:開発はWSL2(Windows環境が必須)、推論APIはDocker(K8s)
選択理由:CADソフト(AutoCAD等)がWindows専用で、Windowsツールとの連携が頻繁に発生しました。APIとして提供するため、コンテナ化が必要でした。
結果:WSL2でWindows/Linux双方のツールを活用しつつ、Docker化でスケーラビリティを確保しました。
よくある質問(FAQ)
Q1: 本番環境をDockerにするリスクは?
Kubernetes等と組み合わせることで、ベアメタル単体より高い可用性を実現できる場合もあります。
Q2: WSL2のGPU性能は実用的か?
推論用途では十分実用的です。ただし、ファイルI/Oが絡む大規模トレーニングでは不利になることがあります。
Q3: 環境を移行する際の注意点は?
依存関係を明示的に管理することが重要です。requirements.txt や Dockerfile で環境を「コード化」しておくと、移行がスムーズになります。
まとめ
社内AI基盤の実行環境は、開発・本番の各段階、チーム構成、性能要件に応じて選定します。選定時の要点は次のとおりです。
- 要件に応じて選ぶ:性能・再現性・運用負荷を比較する
- フェーズごとに使い分ける:開発と本番で異なる環境を使うのは合理的
- 環境の再現性を確保する:DockerやIaCで環境を「コード化」する
- 実測で判断する:GPU推論の差は数%でも、I/Oでは10倍以上の差が生じうる
DigitalBaseでは、中小規模のAI導入において「開発はDocker(再現性とチーム共有)、本番はベアメタルまたはDocker(要件次第)、個人検証はWSL2」という組み合わせを基本に据えています。この構成により、開発効率と本番性能の両立を図っています。